

【マンガで感じる】文字列 ~テキストデータ:文字に対応した番号の配列~ 【本当の基礎から学ぶゲームプログラミング】


2026/08/31

40年以上のゲームプログラミング経験をマンガで可視化。 今回は、コンピューターが扱うテキストデータ「文字列」。 その中身は、各文字に対応した番号「文字コード」の配列です。 文字コードの種類や注意点、コントロールコードなども解説します。
プログラミングブログ記事一覧
[PR]
【マンガで感じる】文字列 ~テキストデータ:文字に対応した番号の配列~


次のエピソードへ

[PR]
「文字列」とは:テキストデータ:文字に対応した番号の配列
「文字列」の本質は「テキストデータ」です。 その実体は、文字に対応した番号の配列です。
この文字に対応した番号は、「文字コード」と呼ばれます。
「文字コード」とは:文字に対応した番号
「文字コード」は、それぞれの文字に対応した番号です。
本エピソードでは、その番号を
0x31 など 16進数で記します。
例えば 0x31 の代わりに、10進数で 49 と表現しても問題はありません。文字コードには種類があり、どの文字にどの番号を当てはめるかが変わりますが、 ここではまず、標準的な文字コードである UTF-8 を用いて解説します。
UTF-8
現在、世界的に使用されている、標準的な文字コードはUTF-8(ユーティーエフエイト)です。
日本語を含めて、全世界で使用されている文字種の多くをカバーしています。
1文字あたりのバイト数は 1バイトから4バイトと、文字種によって異なります。 例えば半角英数は 1バイトで表現され、日本語の文字は 3バイトです。
UTF-8の例
文字
コード
備考
0x20
半角スペース
+
0x2B
-
0x2D
0
0x30
1
0x31
9
0x39
0から9まで連番
A
0x41
Z
0x5A
AからZまで連番
\
0x5C
a
0x61
z
0x7A
aからzまで連番
あ
0xE3 0x81 0x82
ん
0xE3 0x82 0x93
社
0xE7 0xA4 0xBE
長
0xE9 0x95 0xB7
コントロールコード(特殊文字)
文字コードの中には、改行などのコントロールコード(特殊文字)もあります。
コントロールコードの例
コード
略語
記述
意味
0x00
NUL
\0
ヌル文字
0x09
HT
\t
タブ
0x0A
LF
\n
改行
0x0D
CR
\r
復帰
C++ における文字と文字コード
C++ では、文字を 「'」(シングルクォーテーション)で囲うことで扱えます。 型は、エピソード整数で解説した
charを使用します。C++
char c = '1';
c に 0x31 (10進数の 49)が入ります。
数値の 1 とは別物です。「文字列」の実体:文字コードの配列とヌル文字
文字列の実際のデータを、詳細に解説します。
「文字コードの配列」が「文字列」
「文字コード」の「配列」が、文字列です。
C++ において「"」(ダブルクォーテーション)で囲われたもの(文字列リテラル)は、 囲われた文字の文字コードの配列で、最後にヌル文字(
0x00)が自動的に入ります。C++
char sA[] = "1+2";
char sB[] = { 0x31 , 0x2b , 0x32 , 0x00 };
char型配列変数 sA と sB の初期値は、どちらもまったく同じ内容です。文字列終端を示すヌル文字
ヌル文字は、文字列終端を表します。
その意味を表す End of String を略して
EOS とも言い、筆者は好んで使用します。
ただし標準化されたものではなさそうです。このヌル文字を入れて、1バイト文字3つの
"1+2" は 4バイトです。
別の例で "社長" は、3バイト文字2つのため 7バイトになります。なお、長さの情報を別途保持し、文字列終端を使用しないプログラミング言語もあります。
エスケープシーケンス
コントロールコードは、プログラムに記述する方法がある場合があります。 例えばヌル文字は、
'\0' です。このような「
\」(バックスラッシュ・日本語環境だと円マーク)プラス文字(列)の形式で表現するコードをエスケープシーケンスと呼びます。コントロールコードは、エスケープシーケンスを用いて 2文字で表現しますが 1バイトです。
エスケープシーケンスには他にも種類があります。 例えば
'\\' など、特殊な意味を持つ文字を「文字そのもの(この例では 0x5C)」として扱う場合などです。改行コード
コントロールコードの中には、改行の機能を持つ改行コードがあります。 OSにより異なりますので、詳述します。
基本の改行コード(ラインフィード)
基本の改行コードは0x0A です。
C++ を含む主要なプログラミング言語では '\n' が使用できます。
ラインフィード(LF)とも呼びます。例えばコマンドプロンプトなどのターミナル上で、改行コードに対応する言語で記述された
"1\n2" を表示するプログラムを実行すると、1 と 2 が改行を挟んで表示されます。
("1\n2" 表示プログラム実行結果)
1
2
復帰(キャリッジリターン)
改行の関連機能として、キャリッジリターンという、行の先頭に戻る機能があります。 キャリッジリターン(CR)とも呼びます。このコードは
0x0D、 プログラミングでは '\r' を使用します。
"1\r2" を表示するプログラムを実行すると、画面上には、1 の表示が上書きされて 2 のみ残ります。
("1\r2" 表示プログラム実行結果)
2
Windows における改行
Windows はデフォルトで"0x0D 0x0A" ("\r\n") が改行です。例えばメモ帳(notepad.exe)などでファイルを生成すると、各文字は文字コードに変換され、改行コードにはこの2バイトが入ります。
ただし、筆者の経験上、プログラミングにおいては
"\n" だけで問題はありません。Unix における改行
Linux を含む Unix系システムでは0x0A ("\n") が改行コードです。筆者の経験上は、Unix 設定のテキストエディタで Windows のファイルを読むと、
0x0D が特殊文字として表示される場合がありますが、基本的には問題ありません。旧 macOS の改行 (参考)
現在 macOS は Unix のため、前記 Unix と同じです。ただしそれまでの macOS は
0x0D ("\r") のみが改行でした。
三者三様で大変な時代でした。ゲーム機における改行コード
ゲーム機における改行コードは、各ゲーム機ごとに確認が必要です。筆者の経験では、改行コードが問題になった記憶はありません。 ただし、ゲーム機のOS機能が充実している現在、改行付き文字列を渡す機会も増えています。 必要に応じて確認して対応すべきです。
UTF-8以外の文字コード:ASCII・UTF-16・Shit-JIS等
文字コードには UTF-8 以外も存在します。 いくつか解説します。
ASCII
ASCII文字コード(アスキー)は、1バイトの文字コードです。
0x00から0x7Fまで規定されていて、内容は主に半角英数、半角記号、コントロールコードです。
この部分は UTF-8 と完全に一致しています。筆者は、文字コードの煩わしさを避けるため、ASCII文字コードのみで完結する場合は、できるだけそうしています。
UTF-16
UTF-8 は、Unicode(ユニコード) と呼ばれる規格の文字セットを、1から4バイトに符号化(数値化)したものです。
UTF-16 も、Unicode を数値化したものですが、符号化方式が異なり、2バイトまたは4バイトで表現します。 コントロールコードも2バイト、日本語の文字も 2バイトです。
状況によっては UTF-16 の方が効率的に扱える場合があります。 一方で ASCII文字コード部分も 2バイトになるため、注意が必要です。
その他の日本語用文字コード:Shift-JIS・EUC-JP・JIS
日本語用の文字コードは、前述の UTF-8 および UTF-16 以外に、Shift-JIS(SJIS・CP932)、EUC-JP、JIS(ISO-2022-JP) があります。
Shift-JIS(シフトジス or エスジス) と EUC-JP(イーユーシージェイピー or イーユーシー) は、
0x7F 以下が ASCII文字コードと(ほぼ)同じ。
そしてほとんどの日本語の文字を、1バイト目が 0x80 以上の 2バイトで表します。
※Shift-JISの半角カタカナは 1バイトなど違いもありますJIS(ジス) は漢字開始、ASCII開始、などの制御コードのある、文字コードです。
UTF-8 が 3バイトであることを考えると、日本語だけで考えればこれらを使用した方が高効率ですが、現在は主流ではありません。
その他の世界の文字コード
Shift-JIS等が日本語の文字コードであるのと同様に、世界にも様々な文字コードが存在します。
こちらも日本語専用の文字コードと同様に、各国の言語に特化しているのでその範囲では高効率ですが、現在は主流ではない認識です。
各言語に最適化した文字コードが使用されなくなったのは、異なる地域で使用できないからだと筆者は考えます。 世界共通で使用できる UTF-8 など Unicode 系の文字コードは利便性が高く、その利点が非常に大きいです。
BOM 付き UTF-8 とは
通常、ファイルには、どの文字コードが使用されているかの情報がありません。
そのため、ツール等で処理する場合は、文字コードを事前に決めておくか、ファイルの内容からどの文字コードが使用されているかを自動判別します。
それを解消する「BOM(ボム)付き UTF-8」という仕様があります。 UTF-8 のファイルの先頭に
0xEF 0xBB 0xBF という 3バイトを入れて、このファイルは UTF-8 が使用されていることを示すものです。これにより、文字コードの曖昧さを排除して、明確に処理することが可能です。 ただし文字そのもの以外の情報が入っているので、プログラミング時は注意が必要です。
ゲームプログラミングにおける「文字列」
ゲームプログラミングにおいて文字列は、頻繁に使用します。
ゲーム内で使用する文字列の例
例えば、NPCのセリフなど、テキスト表示の際に文字列を使用します。 メニューも、ゲームによっては画像データにしていますが、テキストデータで保持して表示してる場合は文字列です。
多言語対応しているゲームでは、対象言語のファイルを読んで文字列として処理するようにプログラミングをすることで、プログラム本体は同じままで各地域に対応できます。
ゲーム開発支援ツールでの使用例
ゲーム開発を支援するツールのプログラミングでも、文字列の処理は頻繁に行います。
例えばメニューの選択肢は、ゲーム本編では画像化して視覚的にも楽しんでもらうことが少なくありませんが、支援ツールは通常、ツールの開発効率優先で文字列のまま使用します。
文字列操作
文字列操作もよく使用します。 文字列操作とは、例えば部分文字列の取得や、2つの文字列の連結などです。
ただし数値演算とは大きく異なるため、「文字列操作」に関しては後日のエピソードで、改めて詳細に解説予定です。
【職人の視点】JavaScript の === と == の違いとは:型の扱い
エピソード「演算子」 では、JavaScript における「
===」と「==」の違いに触れました。
その後のここまでのエピソードで、解説に必要な情報が揃いましたので、ここで詳細に解説します。一言で説明すると、「
==」は型が違う場合には変換した上で同じかどうか、「===」は型を含めて同じかどうかを返す演算子です。JavaScript
console.log( "2" == 2 );   // true
console.log( "2" === 2 );  // false
==」は「同じ」と判断します。しかし前述の通り、文字列の
"2" と、整数値の 2 は、別物です。
それでも意図的に文字列を数値に変換して判断するように「==」を使用しているのであれば問題ありません。そうでなければ、何らかのミスで、違う型の値が収められている変数同士を比較して、偶然一致と判断されてしまうと紛らわしい不具合になりますので、 原則として「
===」を使用すべきです。【職人の視点】連番文字コードと注意点
UTF-8 では、前述の表の通り
'0'から'9' や、'A'から'Z'、'a'から'z' は文字コードが連番です。つまり例えば
'0'(0x30) + 3 は 0x33 すなわち '3' になります。
経験上、この特性を使用することは多くあります。
文字列が扱いやすく、大きなメリットです。全角も同様に、
'0' (0xEF 0xBC 0x90) から '9' (0xEF 0xBC 0x99) は連番です。しかし、
'一' (0xE4 0xB8 0x80)、'二' (0xE4 0xBA 0x8C) など、漢数字は残念ながら連番ではありません。
そのため 詰将棋など、漢数字を数字として使用するプログラミング時は注意が必要です。【コラム】Shift-JISの「ソ」が不具合?:「5C問題」とは
日本語を表現する文字コードとして UTF-8 がまだ存在していなかった頃、 Shift-JIS を使用する機会が多くありました。
Shift-JISの文字コードは、1バイト目が
0x80 以上なのに対して、2バイト目にその制限が無く、0x5C を含む文字がありました。
具体的は「ソ」(0x83 0x5C) や「能」(0x94 0x5C) などです。(他にも多数)前述の通り「\」(0x5C) はエスケープシーケンスに使用される特殊な文字です。 例えば '\n' は、この2文字で 1バイトの改行コードを表します。
また、当時使用していたプログラミング言語は C でしたが、C言語で文字列に「"」を含めたい場合は「"\""」と書きます。 「\」の次の「"」は、文字列を囲っている記号ではなく「"」という文字です。
C言語
char sSO[] = "ソ";
当時の Cコンパイラ(C言語のプログラムを実行形式にするツール)では、これがコンパイルエラーになりました。 コンパイラが文字列をShift-JISとして厳密に処理すれば対応は可能でしょうが、筆者の経験上は、当時は対応されていないのが普通でした。
このエラーに初めて遭遇した時は、何が問題なのか見当もつきませんでした。 理由がわかっても、例えば「技能」という文字列をゲーム開発で使用したくても、使いづらくて厄介でした。
「
"\\"」が文字の「\」(0x5C)を表すので、char sSO[] = "ソ\"; char sGINO[] = "技能\";
当時筆者はこの問題に名称があることを知りませんでしたが、どうやら「5C問題」と呼ばれているようです。
そして UTF-8 ではこの問題は起きません。便利な世の中になったものだと思います。
[PR]
マンガで感じる!本当の基礎から学ぶゲームプログラミングとは
「マンガで感じる!本当の基礎から学ぶゲームプログラミング」シリーズでは、 主に、ゲーム開発を題材として、プログラミング時に筆者が脳内でイメージするコンピューター内部動作や本質を、マンガにてお伝えします。
プログラミングの本質をマンガで理解
AI時代のプログラミングは、本質理解が重要です。 本質を理解していれば、あとはAIに任せて、自身を持って完成したプログラムに責任が持てるでしょう。
そのため本シリーズでは、コーディングの実例や詳細よりも、「本質をイメージとして感じられること」を最優先としています。 まずマンガで、情報をできる限り絞り、プログラミングの仕組みやコンピューターの内部動作を、物理的に可視化してお届けします。
そして文章の解説で徹底的に深掘りします。
登場人物紹介
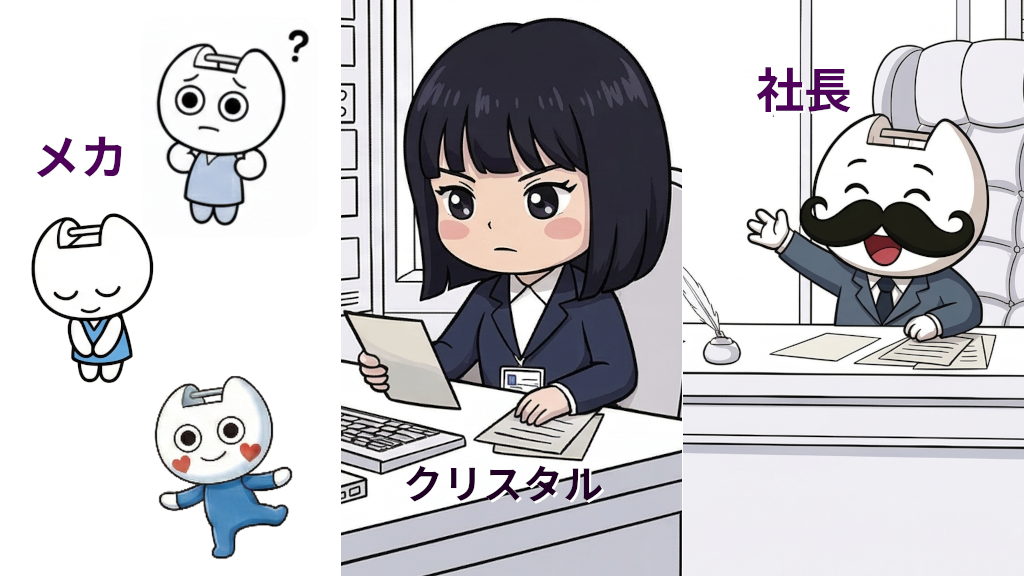 マンガで感じる!本当の基礎から学ぶゲームプログラミングシリーズには、主に社長、クリスタル、およびメカたちが登場します。
※実在の人物とは関係ありません
社長
本シリーズの偉い人です。マンガでは、指示すなわち「要件定義」を行います。
クリスタル
社長の指示を、メカを活用して解決します。名前は、コンピューター内部で指揮者の役割を果たす「水晶発振器」に由来します。
メカたち
用途に応じて多数存在し、果たす役割がそれぞれ与えられています。クリスタルの指示に従い、ある時はプログラムの変数や関数のように、ある時はデジタル回路の素子や部品のように振る舞います。
「マンガで感じる!本当の基礎から学ぶゲームプログラミング」にかける想い
筆者が本シリーズにかける想いや、 より詳しいコンセプトは「マンガで感じる!本当の基礎から学ぶゲームプログラミング」にて語っています。 そちらもぜひご覧ください。
本エピソードから読み始めた方へ
もしあなたがプログラム初心者で、「マンガで感じる!本当の基礎から学ぶゲームプログラミング」シリーズを本エピソードから読み始めた場合は、 ぜひ最初のエピソード「プログラム」から読むことをご検討ください。

AIを専属の家庭教師にして文字列を学ぼう
本記事では、コンピューターが扱うテキストデータである「文字列」について解説しました。
その中身は、文字コードすなわち「文字に対応した番号」の配列です。 関連して文字コードの種類や注意点、コントロールコードなども解説しています。
マンガを読んで興味が湧いた、解説のこのキーワードが気になった、などあれば、AIを専属の家庭教師に見立てて対話してみましょう。 各人の理解度に応じた質疑応答ができて、理解が深まりますので強くオススメします。
皆さまの文字列、およびプログラミングの本質理解に、少しでもお役に立てれば幸いです。
次のエピソードへ
補足
- 本記事に記載のプログラムソースコードは、悪意のない範囲で自由に使用・改変していただいて問題ありません。ただし、ご自身の判断と責任でお願いします。
- 記事内容の検討および検証・添削に生成AIの Anthropic Claude と Google Gemini を利用しております。
- 記事内の画像の作成に生成AIの Google Gemini を利用しております。
- 数式表現にMathJaxを使用しております。
- ※各社の登録商標または商標について「®」「™」等の表記はしておりません。
カテゴリー:マンガで感じる!本当の基礎から学ぶゲームプログラミング,【プロ指向者向け】データ型編
[PR]